Как построить отказоустойчивую инфраструктуру, которая переживёт отказ целого дата-центра
Представьте: ваш сайт или приложение работает. Люди оформляют заказы, читают статьи, смотрят видео. И вдруг всё останавливается. Не на пять минут, а на несколько часов. Причина — не ваша ошибка в коде, а авария в дата-центре, где стоит ваш сервер. Такой сценарий — ночной кошмар для любого бизнеса. Эта статья расскажет, как построить систему, которая продолжит работать, даже если целая площадка с серверами выйдет из строя.
Содержание
Почему один дата-центр — это риск
Дата-центр — это огромное здание, напичканное серверами, системами охлаждения и электропитания. Оно кажется неприступным, но и у него есть уязвимости: пожары, аварии на линиях электропередач, проблемы с сетевым подключением, человеческий фактор или даже природные катаклизмы.
Если весь ваш бизнес «живёт» в одном таком здании, вы ставите всё на одну карту. Распределять нагрузку между серверами внутри одной площадки — это хорошо, но это не спасает, когда недоступен сам дата-центр.
Классический балансировщик внутри одной площадки — как запасной выход, который ведёт в ту же горящую комнату. Он не поможет, если проблема на уровне всего здания.
Что такое GSLB простыми словами
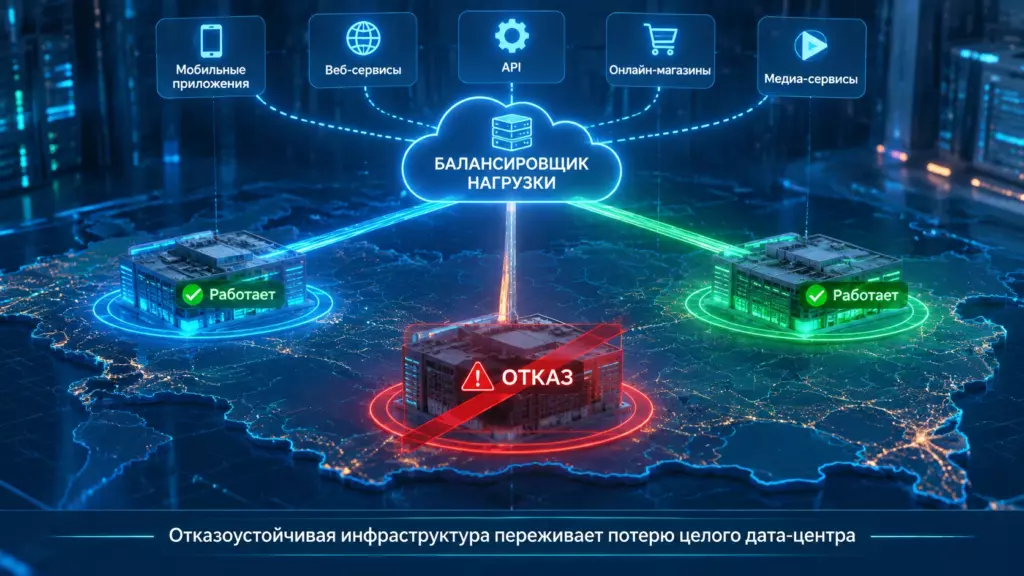
Чтобы пережить отказ целой площадки, нужен «диспетчер» уровнем выше. Он называется GSLB (Global Server Load Balancing) — глобальная балансировка нагрузки. Балансировка приложений на нескольких площадках работает не с отдельными серверами, а с целыми площадками (дата-центрами).
Простая аналогия: представьте два ресторана одной сети в разных районах города. Если один ресторан внезапно закрылся из-за прорыва трубы, администратор сети отправит всех посетителей во второй. GSLB делает то же самое для интернет-трафика.
GSLB направляет пользователя на ближайшую или наименее загруженную работающую площадку. Если одна из них перестаёт отвечать, система мгновенно переключает всех на резервную.
Как GSLB понимает, что площадка «умерла»
Секрет — в постоянных проверках здоровья (health-check). GSLB, как заботливый врач, регулярно «измеряет пульс» каждой площадки. Он отправляет специальные запросы и следит за ответами.
Проверки могут быть простыми: «Ты жив? Ответь «да»». Или более сложными: «Покажи, что твоя база данных отвечает за 0,2 секунды». Когда площадка перестаёт отвечать на эти запросы или отвечает слишком медленно, GSLB считает её неработоспособной и убирает из маршрута.
Интересно, что современные системы health-check могут эмулировать действия реального пользователя: зайти на страницу, положить товар в корзину, попытаться пройти часть оформления заказа. Если виртуальная «покупка» не проходит — трафик на эту площадку не отправляется.
Автоматическое переключение: как это работает
Автоматическое переключение (failover) — это тот момент, когда диспетчер замечает аварию и перенаправляет поток. Всё происходит без участия человека. Пользователь, скорее всего, ничего не заметит: в худшем случае страница перезагрузится чуть дольше обычного.
Обычно процесс выглядит так:
- GSLB замечает, что площадка А перестала отвечать на health-check.
- Система выдерживает короткую паузу (несколько секунд), чтобы исключить ложную тревогу.
- Все новые запросы начинают уходить на площадку Б.
- Площадка А остаётся под наблюдением — как только она «оживает», трафик снова начинает распределяться.
Важно: если вы настроили failover вручную и сидите в этот момент перед монитором — считайте, что вы опоздали. Трафик всегда переключается быстрее, чем человек успевает среагировать. Полагайтесь на автоматику, а не на ручное вмешательство.
Выбор сценария: «активный-активный» или «активный-пассивный»
Когда у вас две и более площадки, нужно решить, какую роль каждая из них будет играть. Есть два основных сценария.
Сценарий «Активный-пассивный»
Одна площадка работает и принимает весь трафик. Вторая находится в режиме ожидания (сна). Когда основная ломается, резервная просыпается и берёт нагрузку на себя.
Это как запасное колесо в машине. Пока основное цело, вы о нём даже не вспоминаете. Но если случился прокол — вы его ставите.
Плюс: простой и понятный. Всегда ясно, где «главный» сервер.
Минус: вы платите за вторую площадку, которая большую часть времени простаивает. Ещё есть риск, что «сонное» оборудование при резком включении может повести себя непредсказуемо.
Сценарий «Активный-активный»
Обе площадки работают одновременно. Каждая принимает часть трафика. Если одна падает, вторая просто начинает обслуживать всех.
Это как два полноценных ресторана, которые работают параллельно. Если один закроется, второй просто примет больше гостей.
Плюс: вы используете ресурсы на полную, нет простаивающего оборудования. Пользователи получают ответы быстрее, потому что нагрузка распределена.
Минус: сложнее в настройке. Нужно следить, чтобы данные между площадками синхронизировались, иначе пользователь, попавший на площадку Б, не увидит заказ, оформленный на площадке А несколько минут назад.
Для проектов с высокими требованиями к доступности современные подходы, как правило, рекомендуют «активный-активный». Это позволяет не только переживать аварии, но и просто обслуживать больше пользователей в обычные дни.
Практические шаги: с чего начать
Если вы хотите защитить свой проект от отказа целой площадки, вот конкретный план действий.
- Выберите двух независимых провайдеров. Не размещайте обе площадки в одном дата-центре и даже в одном городе, если это возможно. Идеально — разные регионы или страны. Тогда локальная авария (отключение электричества в квартале) вас не коснётся.
- Настройте GSLB. Многие облачные провайдеры предлагают эту функцию как услугу. Вам не нужно строить её с нуля. Достаточно правильно указать адреса ваших площадок и настроить проверки.
- Проверьте синхронизацию данных. Убедитесь, что базы данных на обеих площадках копируют друг друга быстро и без ошибок. Это фундамент для сценария «активный-активный».
- Имитируйте аварию. Не ждите реального отказа. Специально отключите одну площадку и посмотрите, как быстро система переключит трафик. Запишите время. Повторите тест в разное время суток.
- Напишите план действий. Даже при идеальной автоматике кому-то нужно знать, как действовать, если авария затянулась. Пропишите, кто отвечает за связь с провайдером, кто информирует пользователей, кто следит за восстановлением.
Частая ошибка новичков: настроить GeoDNS (когда пользователя отправляют на сервер по географическому принципу) и считать, что это решит проблему отказоустойчивости. GeoDNS не проверяет здоровье площадки. Если сервер в Москве перестал работать, а вы настроили просто «москвичей отправлять в Москву», пользователи из Москвы всё равно будут пытаться попасть на мёртвый сервер.
Распространённые страхи и как их побороть
Многие компании откладывают настройку отказоустойчивости из-за мифов и страхов. Разберём два самых частых.
«Это слишком сложно»
Раньше для этого требовалась целая команда сисадминов и недели настройки. Сегодня облачные сервисы делают львиную долю работы сами. Вы часто просто ставите галочки в панели управления и указываете адреса. Конечно, у вас должен быть специалист, который понимает сетевые основы, но это не уровень космических технологий.
«Это слишком дорого»
Да, содержать две площадки дороже, чем одну. Но посчитайте стоимость часа простоя вашего бизнеса. Для интернет-магазина час простоя в горячий сезон может стоить больше, чем месячная аренда резервного сервера. Отказоустойчивость — это не трата, а страховка от гораздо больших потерь.
Выводы: спокойствие стоит вложений
Отказ целого дата-центра — не фантастика, а вопрос времени. Рано или поздно такое случается даже у крупнейших провайдеров. Разница только в том, окажется ли ваш бизнес в числе пострадавших или продолжит работать как ни в чём не бывало.
Глобальная балансировка (GSLB), правильные health-check и автоматический failover — это три кита, на которых держится спокойный сон владельца онлайн-проекта. Начните с простого: выберите второго провайдера, настройте базовое распределение и обязательно проведите учебную тревогу. Увидев, как система легко переживает искусственную аварию, вы почувствуете уверенность, которую не купишь ни за какие деньги.
FAQ: коротко о важном
Что такое GSLB и чем он отличается от обычного балансировщика?
Обычный балансировщик распределяет трафик между серверами внутри одной площадки. GSLB работает на уровень выше — он распределяет трафик между целыми площадками (дата-центрами). Если одна площадка полностью выходит из строя, GSLB переводит всех пользователей на другую.
Что лучше: «активный-активный» или «активный-пассивный»?
Для большинства современных проектов предпочтительнее «активный-активный». Он позволяет использовать ресурсы обеих площадок постоянно и обеспечивает более быстрое переключение при аварии. «Активный-пассивный» проще, но резервное оборудование простаивает и может подвести при резком включении.
Как проверить, что переключение при аварии действительно сработает?
Самый надёжный способ — запланированная учебная авария. Специально отключите одну площадку и посмотрите, переключится ли трафик автоматически, сколько это займёт времени. Такие проверки стоит проводить регулярно, например, раз в квартал.